
ASAM ODS 赋能 AI/ML 解决方案
ASAM 国际会议,2024年12月4-5日,德国慕尼黑
在大多数情况下,标准化在涉及创新和与最新技术趋势集成时被视为阻碍。然而,在本文中我们说明, ASAM ODS 标准 ——它适合长期且面向未来的数据管理——已经提供了所需的构建模块,用于以适合机器学习的方式准备和存储测试数据,以及如何通过标准分析和机器学习工具访问数据,并获得 AI 智能体的支持。
数据分析流程
为了确定所需和现有的构建模块,我们首先来看看数据分析的整体流程。从问题定义开始,该流程定义了获得数据驱动洞察与改进的各个步骤: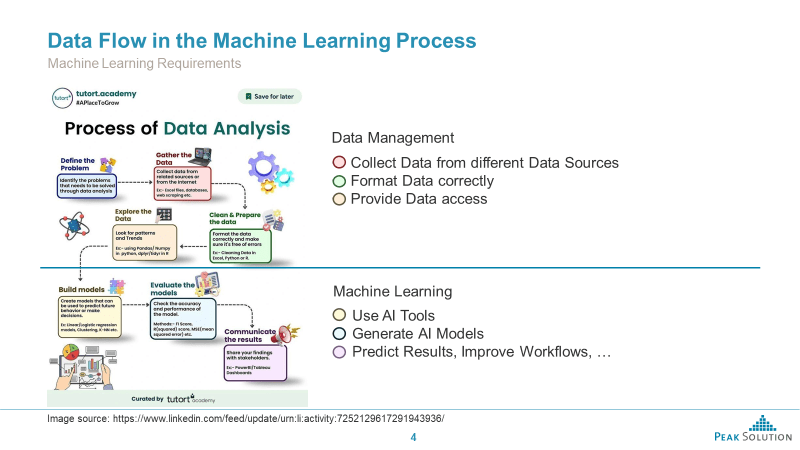
- 从以下来源采集数据
不同来源
- 格式化与
存储数据
- 提供访问权限
数据
- 使用 AI 工具
- 生成 AI 模型
- 预测结果,
改进工作流,……
各个步骤可分为
分为两个部分: 数据管理要求 和 机器学习 (ML) 应用。
让我们从数据管理要求开始。
面向机器学习的数据管理要求
这三大需求涵盖了数据管理的以下领域:
- 数据采集 ——从不同来源采集数据
- 数据存储 与数据格式
- 数据访问
数据管理的艺术在于:将数据管理与现有 IT 环境集成、高效存储数据、维护数据上下文,并最终以适合连接现有和未来工具的方式提供数据。让我们逐一审视这三项要求。
数据采集
数据采集是将组织的各个数据孤岛与您的数据管理解决方案连接起来的过程。将 ASAM ODS 视为一种可能的解决方案时,您会发现有多种方式将数据采集并导入 ASAM ODS 服务器。对于以下用例 保持现有工具链完好,就需要一种导入机制,使数据(文件)保持原有的格式与位置,并提供所需的元数据,将数据纳入 ASAM ODS 服务器的正确上下文中。
ASAM ODS 扩展数据 API,简称 ASAM ODS ExD 插件 满足这些要求。它们以 gRPC 服务的形式实现,并提供用于检索海量数据和元数据的简单 API,因而非常契合。简而言之,借助 ASAM ODS ExD 插件,您可以:
- 访问“任何”类型的数据
- 避免数据转换与数据重复
- 让现有工具链继续可用
- 使用“任意”编程语言
- 保持较低的研发投入
您可以找到有关如何开发和测试 ASAM ODS ExD 插件的示例,详见 此处:
数据存储与数据格式
从零开始时,找到正确的数据存储与格式化方式是一项可能耗费大量时间和资源的工作。与其自己摸索数据存储方式,我们建议先了解一下 ASAM ODS 标准。ASAM ODS 以通用的方式定义了物理数据存储及相应的数据访问,让您可以借助所谓的基础数据模型来定义自己特定的数据需求:
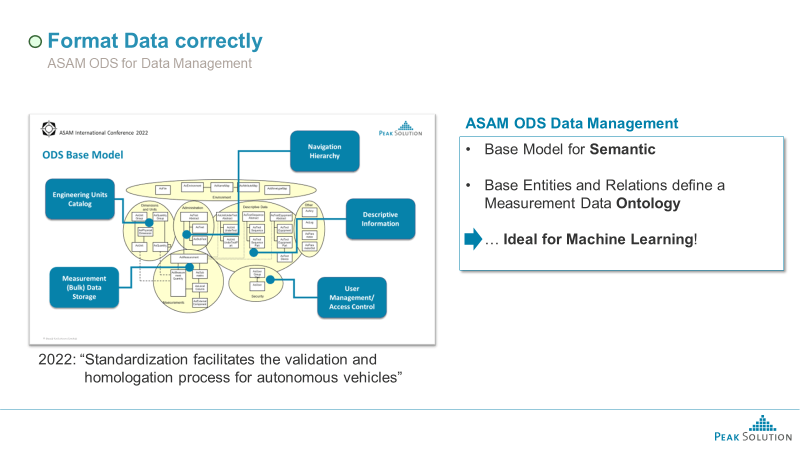
基础模型引入了额外的语义,用于定义数据的含义与解读方式。此外,通过添加数据上下文以及针对重复出现内容的目录,您就已经定义了 数据本体.
数据访问
需要数据访问或数据连接,以便提供存储在 ASAM ODS 服务器 提供给各个客户端。除此之外,ASAM ODS 还提供了通过 HTTP-API 的数据访问。然而,现有的 API 非常针对 ASAM 工具,无法与 Python 分析和机器学习库及工具无缝集成。
让我们在下一章中看看这个问题是如何被解决的……
连接机器学习工具
为详细说明机器学习工具与应用的需求,让我们来看看典型数据科学家的职位画像与技能:
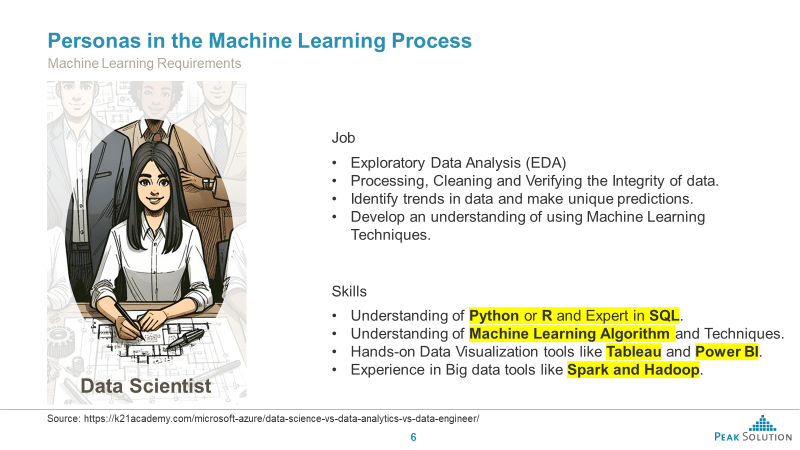
工具清单可归纳如下:
- Python 或 R 和 SQL
- 机器学习算法
- Tableau 和 Power BI
- Spark 和 Hadoop
Python 与机器学习算法
Python 是数据科学家的“通用语言”,大多数机器学习库都提供 Python 版本。要使用这些库,数据需要以 DataFrame 形式提供。这正是开源 ODSBox 如何融入其中。作为构建在 ASAM ODS API 之上的小型封装,它将典型的 ODS 数据转换为 DataFrame。一旦通过 (pip) 安装好 ODSBox,您就可以使用最强大的 Python 机器学习库了。
Power BI
在 Microsoft Power BI 中导入 ASAM ODS 数据的方案遵循相同的思路。借助现有的 Python 数据导入,ODSBox 提供的 DataFrame 可被 Microsoft Power BI 直接加载。
Spark 与 Hadoop
要让您的 ASAM ODS 数据在 Apache Hadoop 生态系统中可用,需要采用不同的方式。Hadoop 生态系统中使用的分析工具最适合处理 Apache Avro 或 Apache Parquet 格式的数据。此处的解决方案直接来自 ASAM ODS 组件栈。
ASAM Big ODS 关联标准定义了如何借助 XML 定义文件,将存储在 ASAM ODS 服务器中的数据导出为 Apache Avro 或 Apache Parquet 文件。这一导出的自动化可以借助 Spark 实现。除了将数据导出为所需的 Hadoop 数据格式外, Spark SQL 和 DataFrame 是大数据分析的额外构建模块。
借助 AI 智能体获取支持
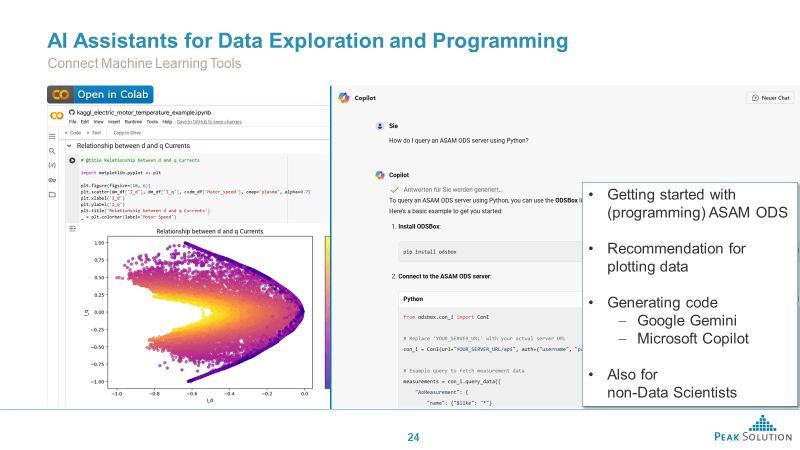
既然我们已经证明 ASAM ODS 数据可用于机器学习,我们甚至可以更进一步,使用 Google Gemini 或 Microsoft Copilot 等 AI 智能体来支持我们的数据分析任务。当使用诸如以下位置提供的 Jupyter Notebook 时 数据管理学习路径 您可以将这些 Notebook 加载到 Google Colab、Github Codespaces 或 Microsoft Fabric。现在,您可以使用这些平台的 AI 智能体来帮助您创建更复杂的图表,或为您的分析任务生成数据查询。
结论与执行摘要
作为结论可以说, 数据管理 技术组件—— ASAM ODS ——支持以下方面的通用要求: 机器学习。与诸如以下开源软件相结合, ASAM ODSBox,典型的 Python 机器学习 工具与分析库 可供以下人员使用: 数据科学家。此外,ASAM ODSBox 还弥合了与 Microsoft 之间的鸿沟 Copilot、Google Gemini 或其他 AI 智能体 更快、更高效地创建解决方案——即便对于 非数据科学家.
本文总结了 2024 年 12 月 4 日至 5 日在德国慕尼黑举行的 ASAM 国际会议上的演讲。
您可以在此处下载原始演讲稿
互联解决方案
您可以点击这些链接,了解各个组件的更多信息。
Peak Test Data Manager
Peak Test Data Manager 是一个面向未来的测试数据管理系统,将各个数据管理组件整合在一起。
Peak ODS-Server
长期数据存储,包含用于标准化、安全数据访问的 API
Peak ODS Adapter for Apache Spark
基于 Apache Spark 的可扩展数据访问。
Peak ASAM ODSBox
轻量级 Python 工具包,实现无缝的 ASAM ODS 数据访问与分析
相关主题
Python ASAM ODS Utilities
用于在 Python 中使用 ASAM ODS 数据的开源库与示例。
什么是 ASAM ODS?
ASAM ODS 标准定义了用于存储和检索测试与测量数据的 API 和格式。
什么是数据模型?
数据模型定义了测量数据的数据语境。
什么是 ASAM ODS EXD-API 插件?
ASAM ODS EXD-API 插件通过 gRPC 微服务提供对库存数据的访问。
